Konwersacyjne AI
Rozmowy ukierunkowane na intencje, pamięć kontekstu, właściwy ton i płynne przekazanie wątku człowiekowi, gdy sytuacja tego wymaga.
Oprogramowanie projektowane z intencją
Chronox Software projektuje i buduje inteligentne systemy, od konwersacyjnego AI po bazy danych, które trzymają je w ryzach. Wszystko mierzymy. Dwa razy.
Dlaczego istniejemy
Upraszczamy inteligentne oprogramowanie. Budujemy systemy, które działają wyprzedzająco, tłumaczą swoje decyzje i nigdy nie zawodzą, aby Twój zespół mógł skupić się na tym, co naprawdę przynosi wyniki.
Czym się zajmujemy
Sześć specjalności, jeden zespół. Sprawdź, jak łączymy symulacje procesów z inżynierią oprogramowania.
Rozmowy ukierunkowane na intencje, pamięć kontekstu, właściwy ton i płynne przekazanie wątku człowiekowi, gdy sytuacja tego wymaga.
Skalowalne schematy, zapytania, które nie zwalniają wraz ze wzrostem danych, oraz migracje przeprowadzone bezstresowo.
Systemy wspomagania decyzji, które wzmacniają Twój zespół, zamiast go zastępować.
Od surowych zdarzeń po czytelne dashboardy, do których dyrektor finansowy zagląda z przyjemnością.
Wydajne interfejsy oraz procesy w tle, które działają niezawodnie i bezobsługowo.
Kafelki powyżej to obszary, w których mamy największe doświadczenie. Najciekawsze projekty to jednak te, które wykraczają poza utarte schematy. Powiedz nam, gdzie tkwi problem, a zaprojektujemy oprogramowanie, które go rozwiąże
Interaktywnie
Symulacja naszego AI konwersacyjnego. Ta demonstracja jest w pełni skryptowana; prawdziwy silnik wdrożymy w Twojej firmie.
 Chrono
Symulacja
Co oferujemy
Każde zlecenie zaczyna się od krótkiego audytu. Rozwiń sekcję, aby zobaczyć co wykonujemy.
Wzbogacamy Twoje procesy o algorytmy uczenia maszynowego. Budujemy systemy scoringowe, prognozy popytu, alerty o anomaliach i silniki rekomendacji. Człowiek zachowuje pełną kontrolę, a każdy wniosek AI otrzymuje proste, zrozumiałe wyjaśnienie.
Inteligentni asystenci na stronach WWW, w komunikatorach i kanałach głosowych. Odpowiadamy za pełny stack: od projektowania intencji i architektur RAG, po bezpieczeństwo danych, analitykę i płynne przekazanie rozmowy człowiekowi w kluczowych momentach.
Architektura baz danych, optymalizacja wydajności i migracje. Projektujemy schematy, które rosną razem z Tobą, piszemy SQL, który pozostaje czytelny i pilnujemy, by model danych był spójny.
Potoki danych, magazyny i dashboardy. Zamieniamy rozproszone logi i arkusze w jedno zaufane źródło liczb oraz raporty, które management faktycznie czyta.
Aplikacje i portale internetowe tworzone na wymiar: od systemów intranetowych po produkty B2B i B2C. Szybkie, bezpieczne i stabilne tak bardzo, że po wdrożeniu po prostu zapominasz o ich istnieniu.
Jeśli jakieś zadanie sprowadza się do „kopiuj-wklej”, powinien wykonywać je skrypt. Automatyzujemy integracje między odizolowanymi systemami, oddając Twojemu zespołowi czas na wyzwania, które naprawdę wymagają ludzkiego myślenia.
W środku
Szczegółowe materiały o rozwiązaniach, które wdrożyliśmy: jak działały, co zawierały i co rozwiązywały.
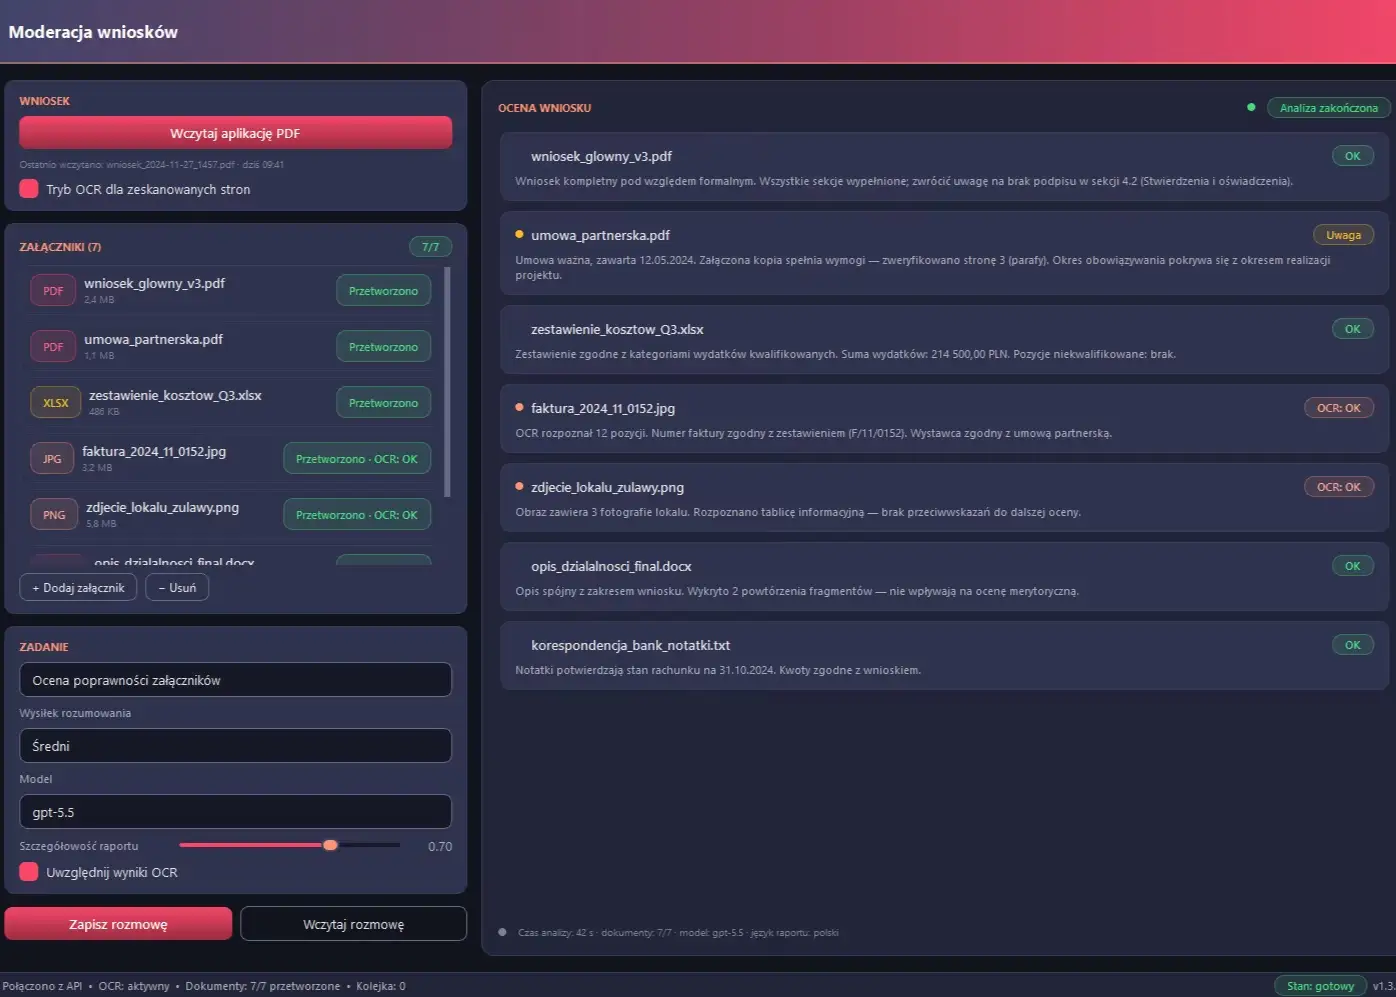
Wnioskodawca składa wniosek główny wraz z pakietem załączników: PDF-y, pliki Word, arkusze, skany. Zanim cokolwiek trafi do modelu, warstwa kliencka przepuszcza obrazy i dokumenty Word przez Azure Document Intelligence (prebuilt-read) i normalizuje pozostałe formaty (ODT i ODS są najpierw konwertowane do DOCX i XLSX), więc strumień operuje wyłącznie na tekście. Backend nie przetwarza surowych plików.
Kryteria programu naborów definiuje się w pliku CSV: dla każdego kryterium nazwa, maksimum punktów i przedziały punktowe, każdy przedział z własnym warunkiem i uzasadnieniem, a całość składa się na strukturalny plik reguł. Do promptu trafiają: wniosek główny, każdy załącznik pod własnym markerem sekcji, plik wiedzy stałej i podsumowanie poprzedniej oceny, więc drugi przebieg opiera się na tym, co ustalił pierwszy, zamiast zaczynać od zera.
Pełna ocena przekracza 240-sekundowy limit nieaktywności platformy, więc żądanie zwraca status 202 i identyfikator zadania; klient odpytuje o status po tym identyfikatorze, a kolejka obsługuje zadania trwające do 15 minut, wysyłając heartbeat co 30 sekund. Model jest wybierany według oszacowanej liczby tokenów: główny deployment, gdy payload się mieści, automatyczny fallback, gdy nie. Każda odpowiedź jest weryfikowana przez Azure Content Safety z maksymalnie dwiema regeneracjami; jeśli trzecia próba też nie przejdzie, zwracana jest bezpieczna, przygotowana z góry odpowiedź zamiast surowego wyniku modelu.
Wynikiem jest werdykt dla każdego kryterium: punkty, cytat z dokumentu źródłowego i uzasadnienie zrozumiałe nawet dla osoby spoza dziedziny. Urzędnik przegląda go linia po linii.
Przed wdrożeniem ten przebieg wykonywano ręcznie: czytano każdą stronę wniosku i jego załączników, przechodzono po kolei przez kryteria; całość zajmowała godziny i zależała od formy oceniającego. System wykonuje pierwszy pełny przebieg w kilka minut, stosuje wobec każdej sprawy tę samą kolejność kontroli i przenosi ciężar pracy urzędnika z czytania na weryfikację. Gdy zmieniają się reguły programu naborów, zmiana działa jeszcze tego samego dnia roboczego, a następna ocena idzie już według zaktualizowanych reguł, bez żadnej zmiany oprogramowania.
Utrzymanie jest celowo lekkie: nowy program naborów to edycja CSV, pliki wiedzy znajdują się w Blob Storage i są wczytywane od nowa co trzy godziny, a osobne klucze API pozwalają temu samemu backendowi obsługiwać i punktowanie, i weryfikację załączników, i kontrolę błędów, i wypełnianie kart, bez ponownego wdrożenia.
Baza wiedzy to folder z dokumentami, a strumień treści jest celowo prosty. Indexer uruchamiany codziennie pobiera pliki z Azure Blob Storage, dzieli strony na fragmenty do 2000 znaków z 500-znakowym nakładem, żeby informacja nalająca się na granicę była zachowana po obu stronach, embeduje fragmenty w 1536 wymiarach i indeksuje wynik przez HNSW. Każdy fragment zawiera też do dziesięciu wyodrębnionych fraz kluczowych i odnośnik do strony nadrzędnej.
Zapytanie idzie oboma torami wyszukiwania naraz: BM25 po treści fragmentu, tytule (waga 3,0) i frazach kluczowych (waga 2,0), spięte z zapytaniem wektorowym fuzją RRF. Jeden round trip, oba tory, wykonywane po stronie serwera.
Połączone wyniki trudno bezpośrednio porównywać między torami, więc strumień robi reranking po swojemu: normalizacja min-max na całej partii kandydatów (z zabezpieczeniem od wariancji, żeby przy wyrównanej partii zachować kolejność zwróconą przez serwer), a potem skalowanie potęgą 0,7, które rozsuwa wyniki sklejone w jednym miejscu. Kilka linijek matematyki zastępuje dedykowany reranker, którego warstwa wyszukiwania nie oferuje, a indeks zachowuje się, jakby go miał. Najlepsze pięć fragmentów jest zwracanych razem ze źródłem, punktacją i trybem, który je znalazł.
Asystent pracuje przez natywne wywołania funkcji: narzędzie wyszukiwania, które obsługuje zapytania hybrydowo, wektorowo albo tekstowo, i narzędzie dokumentów, które wyciąga pełny tekst PDF lub Worda, gdy fragmentu nie wystarcza. Dopuszcza osiem rund i do dwudziestu czterech wywołań narzędzi, równolegle, gdzie to możliwe; po wyczerpaniu budżetu dostaje polecenie, by odpowiedział na podstawie tego, co już ma. Gdy embedding się zawiesi, zapytanie schodzi do trybu tekstowego, a każda odpowiedź jest sprawdzana pod kątem oparcia w pobranym kontekście, zanim opuści API.
Przed wdrożeniem pytanie w supporcie oznaczało ręczne znalezienie właściwego dokumentu, przeczytanie go i napisanie odpowiedzi od zera, a to samo pytanie za każdym razem odpowiadano od nowa. Asystent odpowiada na podstawie konkretnej strony, którą przeczytał, i dokleja do niej numer oraz punkt wyszukiwania, w takim samym standardzie o 21:00 co o 9:00. Czas zespołu zostaje dla spraw, które wymagają ludzkiego osądu.
Sekrety są przechowywane w Azure Key Vault, a usługa uwierzytelnia się managed identity, więc żaden statyczny klucz nie znajduje się w samej usłudze. Jedna Logic App restartuje serwis codziennie (GC, odświeżenie połączeń), druga wysyła logi do Blob Storage, a endpoint zdrowotny raportuje stan healthy albo degraded. Dodanie dokumentu do bazy to wrzucenie pliku; następny przebieg indexera go podłapie i nic innego się nie rusza.
Wdrożenie objęło zestaw produkcyjnych instancji PostgreSQL na Amazon RDS, każdą z własnym harmonogramem. Wewnątrz serwera bazy danych nie dzieje się nic: silnikiem jest flota funkcji AWS Lambda uruchamianych regułami EventBridge, ze stanem w DynamoDB i jednym plikiem konfiguracyjnym na instancję w S3. Baza widzi wyłącznie zwykłe zapytania SQL przez standardowe połączenia.
Każdy przebieg zaczyna się od pomiaru: rozmiary tabel i indeksów względem poprzedniego przebiegu, degradacja oszacowana przez pgstattuple, martwe krotki z kolektora statystyk oraz stopień nieaktualności statystyk planera. Silnik przechowuje dla każdego obiektu szereg czasowy w DynamoDB, więc próg to porównanie z trendem, nie z ustaloną wartością: degradacja jest zgłaszana, gdy rośnie przez pięć przebiegów z rzędu, nie wtedy, gdy jednokrotnie przekroczy próg.
Drugi tor obserwuje plany zapytań. Najważniejsze zapytania z pg_stat_statements są co noc przechwytywane jako znormalizowane drzewa planów, a następny przebieg wykonuje EXPLAIN dla każdego z nich. Gdy plan się przewróci, skan indeksowy zamienia się w sekwencyjny albo zmienia się kolejność łączenia, a różnica trafia do raportu razem z drzewami sprzed i po, obok siebie. Regresja planu jest łapana w porannym raporcie, nie w zgłoszeniu, które wywołała.
Tabele z partycjonowaniem czasowym są prowadzone zgodnie z polityką: silnik tworzy partycje kolejnego miesiąca przed końcem bieżącego, usuwa wygasłe zgodnie z plikiem retencji, a gdy brakuje wymaganego ograniczenia, rezygnuje z obu kroków i zgłasza lukę, zamiast zgadywać. Sekwencje blisko maksimum są synchronizowane i raportowane, a blokady przekraczające ustalony próg są przechwytywane razem z zapytaniem oczekującym, zapytaniem blokującym i wiekiem transakcji.
Przed wdrożeniem konserwacją była lista kontrolna na wiki, której nikt nie przechodził: degradację znajdowano w incydencie, trzy tygodnie po tym, jak zaczęła rosnąć, a regresje planów znajdowano w zgłoszeniu, które wciąż było otwarte. Lista stała się pomiarem, a incydent wierszem w porannym raporcie. Ciężar pracy inżyniera przenosi się z odhaczania listy na rozstrzyganie kilku wierszy, które naprawdę wymagają decyzji.
Utrzymanie jest celowo proste: dodanie instancji to jeden plik konfiguracyjny w S3 i jedna reguła EventBridge, sam silnik się nie zmienia. Funkcje nie mają zaszytych statycznych danych dostępowych, każda uwierzytelnia się rolą IAM ograniczoną do własnej bazy, a kanał raportu to jedyne miejsce, w którym pojawia się człowiek.
Aplikacja desktopowa działa na komputerze klienta i jedynym ruchem wychodzącym z maszyny jest zapytanie inferencyjne. Wejściem jest to, co księgowa już ma: eksporty wyciągów bankowych, faktury PDF i pliki docierające mailem. Lokalna warstwa najpierw normalizuje formaty, więc model nigdy nie widzi surowego pliku, a lokalna księga w SQLite na tej samej maszynie to jedyny magazyn danych.
Inferencja idzie przez OpenRouter z flagą zerowej retencji ustawioną w każdym żądaniu, więc dostawca jest umownie zobowiązany do nieprzechowywania payloadu; model jest wybierany z zestawu kwalifikującego się do ZDR, a nie po prostu najszybszego albo najtańszego. Dokumenty księgowe to jedyny rodzaj pliku, w którym „model to widział” nie jest akceptowalnym końcem zdania. Model nigdy nie widzi całej księgi, tylko kawałka, o który jest proszony: jednej faktury, jednej pozycji wyciągu, jednej pary do dopasowania.
Warstwa LLM czyta: klasyfikuje wpis, dopasowuje kontrahenta do istniejących nazw w księdze, wyciąga z faktury kwotę, podatek, datę i pozycje oraz łączy pozycje wyciągu z fakturami, które opłacają, w oknie czasowym i z tolerancją kwotową. Każda ekstrakcja to strukturalne pole, nie zdanie, i każde pole jest walidowane lokalnie: pozycje sumowane od nowa i porównywane z kwotą całkowitą, podatek przeliczany od stawki, data sprawdzana względem wyciągu. Pole, które nie przejdzie walidacji, wraca do modelu raz; jeśli zawiedzie ponownie, trafia do kolejki weryfikacji wraz z zapisanym powodem.
Wpisy powyżej progu pewności księgują się same; reszta czeka w kolejce weryfikacji z tym, co maszyna zobaczyła, i z tym, w czym nie była pewna, więc człowiek czyta wątpliwość maszyny, nie fakturę. Każdy zaksięgowany wpis jest odwracalny jednym ruchem, a odwrócenie jest logowane jak każdy inny wpis, więc ślad audytorski nie ma dziury. Miesięczny raport to lista tego, co jest otwarte: niedopasowane pozycje, faktury bez pasującej pozycji w wyciągu i różnica między podatkiem należnym a naliczonym.
Przed wdrożeniem miesiąc zamykano po staremu: faktury czytane ręcznie, wpisy przepisywane do księgi, dopasowanie robione na oko, zamknięcie mierzone w dniach, a błędy znajdowane później, przez audytora. Maszyna czyta i dopasowuje; księgowa robi kilka rzeczy, które wymagają osądu, a zamknięcie mierzy się w godzinach. Księgi zostają na maszynie, na której zawsze były.
Utrzymanie jest celowo ciche: aplikacja aktualizuje się sama, lista modeli jest wczytywana codziennie od OpenRouter, więc nowy model kwalifikujący się do ZDR trafia do puli bez nowej wersji, a warstwa LLM ustawia zadania w kolejce offline i rusza, gdy połączenie wróci. Księga, konfiguracja i logi zostają na maszynie; jedyny ruch zewnętrzny to kanał inferencyjny z flagą retencji, którą dostawca zobowiązuje się uszanować.
Ludzie
Zespół inżynierów i analityków danych, którym zależy na szybkim, uczciwym i kształtującym przyszłość oprogramowaniu.
Utrzymanie i kontakty zewnętrzne
Dba o działanie systemów po wdrożeniu: monitoring, aktualizacje i reagowanie na incydenty. Przedstawia Chronox na wydarzeniach branżowych i spotkaniach z partnerami.
Wdrożenia i badania
Przekłada badania naukowe na systemy informatyczne. W ostatnich latach zajmował się prywatnie aplikacjami, utrzymaniem systemów, bazami danych, przetwarzaniem obrazów i uczeniem maszynowym.
Marketing i finanse
Zajmuje się marketingiem i finansami: kampaniami, budżetem i planowaniem, dzięki czemu projekty trzymają się harmonogramu.
Chronox Software powstał w 2025 roku w Katowicach. Jesteśmy zespołem trzech wysoko wykwalifikowanych i certyfikowanych osób. Tworzymy oprogramowanie dla firm, które oczekują systemów łatwych w prowadzeniu i przewidywalnych w utrzymaniu. Pokażemy branży, jak wygląda przyszłość, i zbudujemy Wasz projekt, zanim zrobi to konkurencja.
Co słychać
Opinie naszych klientów o współpracy i zrealizowanych projektach.
Profesjonalna firma. Korzystając z usług otrzymałem szybkie i efektywne wdrożenie pomocnego narzędzia do automatycznej oceny wniosków. Wszystko działa poprawnie, polecam
Zbudowali mi aplikację do kontaktu z klientami. Działa od pierwszego dnia. Wiadomości nie giną, a ja przestałam ręcznie pilnować skrzynki.
System rezerwacji po prostu działa. Na każdą wizytę klienta wchodzimy przygotowani.
Nasz zespół musiał łączyć dane z trzech systemów, żeby wiedzieć, gdzie jest cargo. Teraz same trafiają do jednego dashboardu. O problemach dowiadujemy się, zanim zadzwoni klient.
Raporty na koniec miesiąca zabierały dwa dni. Teraz są gotowe, zanim zacznie się spotkanie.
Skontaktuj się z nami
Opowiedz nam o swoim projekcie, danych albo procesie, który jest problematyczny. Odpowiemy w jeden dzień roboczy.
Prawne
Ostatnia aktualizacja: listopad 2026
Administratorem danych osobowych przetwarzanych na tej stronie jest Chronox Software, ul. Miodowa 5, 41-940 Piekary Śląskie, Polska (NIP 4980280966, REGON 543704440), dalej „Administrator”. Z administratorem można kontaktować się pod adresem: contact@chronoxsoftware.com.
Złożenie zapytania przez formularz kontaktowy oznacza przekazanie imienia i nazwiska, adresu e-mail oraz treści wiadomości. W związku z korzystaniem ze Strony, w ramach świadczenia usługi, podmioty techniczne (hosting, Cloudflare) przetwarzają dane połączeniowe, w tym adres IP, niezbędne do dostarczania treści i zapewnienia bezpieczeństwa działania usługi. Ponadto Strona korzysta z usługi Google Tag Manager do zarządzania skryptami pomiarowymi i analitycznymi, co może wiązać się z przetwarzaniem danych technicznych i o aktywności na stronie, takich jak odsłony, zdarzenia nawigacyjne, informacje o urządzeniu i przeglądarce oraz adres IP.
Dane przekazane przez formularz kontaktowy przetwarzamy wyłącznie w celu odpowiedzi na zapytanie, tj. podjęcia działań na żądanie osoby, zanim zawrze się umowę, w rozumieniu art. 6 ust. 1 lit. b RODO. Dane z formularza kontaktowego nie są udostępniane podmiotom trzecim w celach reklamowych. Dane techniczne i o aktywności przetwarzane za pośrednictwem Google Tag Manager są wykorzystywane do pomiaru ruchu, diagnostyki serwisu oraz oceny skuteczności działań informacyjnych Administratora na podstawie prawnie uzasadnionego interesu Administratora (art. 6 ust. 1 lit. f RODO) lub, w zakresie wymaganym przepisami prawa dla opcjonalnych plików cookies lub tagów, na podstawie zgody Użytkownika (art. 6 ust. 1 lit. a RODO).
Przy świadczeniu usługi biorą udział zewnętrzni dostawcy i podmioty przetwarzające działające na polecenie Administratora: Cloudflare, hostujący stronę i obsługujący ochronę formularza (Cloudflare Turnstile), Zoho, dostarczający wiadomości do skrzynki Administratora przez Zoho Mail, oraz Google (Google Ireland Limited / Google LLC), dostarczający usługę Google Tag Manager oraz ewentualne tagi pomiarowe lub reklamowe uruchamiane za jego pośrednictwem. W przypadku przekazania danych poza Europejski Obszar Gospodarczy odbywa się ono na podstawie odpowiednich zabezpieczeń prawnych, takich jak standardowe klauzule umowne lub decyzje stwierdzające odpowiedni stopień ochrony (w tym EU-US Data Privacy Framework).
Dane przechowujemy do czasu rozstrzygnięcia sprawy i w każdym przypadku nie dłużej niż 5 lat od ostatniego kontaktu, chyba że dłuższy okres przechowywania jest wymagany przez przepisy prawa, w tym przepisy rachunkowe lub podatkowe.
Osoba, której dane dotyczą, ma prawo wnioskować o dostęp do swoich danych, ich sprostowanie lub usunięcie, ograniczenie lub wyrażenie sprzeciwu wobec przetwarzania, a także przeniesienie danych. Prawa można wykonywać, a skargę złożyć do organu nadzorczego, Prezesa Urzędu Ochrony Danych Osobowych (UODO), pisząc na contact@chronoxsoftware.com.
Strona nie ustawia własnych plików cookies dla preferencji użytkownika. Trzy preferencje są przechowywane w pamięci lokalnej przeglądarki: motyw kolorów, język wyświetlania oraz jednorazowa flaga zapisująca fakt wyświetlenia podpowiedzi przewijania nawigacji. Usługi podmiotów trzecich zintegrowane ze Stroną, tj. Cloudflare Turnstile (niezbędny do ochrony formularza kontaktowego) oraz Google Tag Manager (wraz ze skonfigurowanymi w nim tagami), mogą zapisywać pliki cookies lub korzystać z podobnych mechanizmów przeglądarki. Szczegóły znajdują się w Polityce plików cookies.
Prawne
Ostatnia aktualizacja: listopad 2026
Sama Strona nie ustawia plików cookies na potrzeby działania interfejsu ani zapisywania preferencji użytkownika. Przechowuje trzy wpisy konfiguracyjne w pamięci lokalnej przeglądarki: motyw kolorów (jasny lub ciemny), język wyświetlania (EN lub PL) oraz jednorazową flagę informującą, że podpowiedź przewijania nawigacji została już wyświetlona. Żaden z tych wpisów nie zawiera danych osobowych i żaden nie jest przekazywany poza przeglądarkę Użytkownika. Dodatkowe pliki cookies mogą być jednak zapisywane przez usługi podmiotów trzecich opisane poniżej.
Czcionki są dostarczane wyłącznie z własnego serwera strony i nie są pobierane ze źródeł zewnętrznych. Formularz kontaktowy chroni usługa podmiotu trzeciego, Cloudflare Turnstile, uruchamiana wyłącznie po otwarciu sekcji kontaktowej w celu zapobiegania automatycznym nadużyciom; jej plik ochronny jest ściśle niezbędny do działania formularza. Strona ładuje również usługę Google Tag Manager (dostarczaną przez Google), służącą do zarządzania tagami pomiarowymi, analitycznymi oraz konwersji kampanii reklamowych. W zależności od konfiguracji aktywnych tagów w kontenerze Google Tag Manager usługi Google mogą zapisywać pliki cookies lub odczytywać identyfikatory przeglądarki w celu pomiaru ruchu i atrybucji kampanii.
Plik ochronny Cloudflare Turnstile jest ściśle niezbędny do zabezpieczenia formularza kontaktowego, a trzy wpisy w pamięci lokalnej przechowują wyłącznie nieosobowe ustawienia interfejsu. W zakresie, w jakim tagi skonfigurowane w Google Tag Manager korzystają z opcjonalnych plików cookies, ich działanie podlega odpowiednim ustawieniom zgód lub ustawieniom przeglądarki Użytkownika. Użytkownik może w każdej chwili zablokować, ograniczyć lub usunąć pliki cookies oraz wyczyścić pamięć lokalną tej strony w ustawieniach swojej przeglądarki (zablokowanie niezbędnych mechanizmów może jednak uniemożliwić wysłanie formularza kontaktowego).